

STREAMED UP ist die führende medizinische Videoplattform für Online Fortbildung, um immer auf dem neuesten Stand zu sein.
STREAMED UP ist die führende medizinische Videoplattform für Online Fortbildung, um immer auf dem neuesten Stand zu sein.
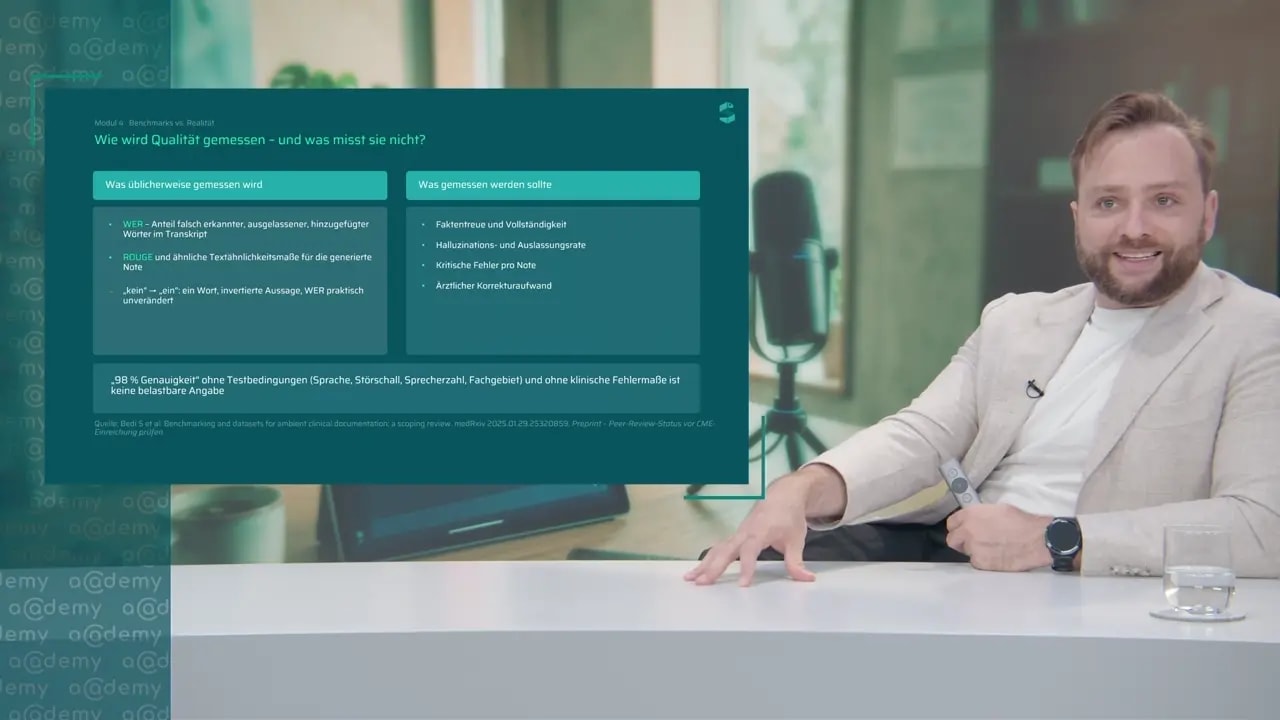
Wie wird Qualität gemessen und was misst sie nicht?
Was öffentliche Benchmarks zeigen und was nicht
Leise Fehler mit lauter Wirkung
Dialekte, Akzente, Sprachvielfalt
Vier Forderungen an Anbieter
Wissenschaftliche Leitung
Ärztlicher Unternehmer & Digital-Health-Experte, Partner und CEO @ aiomics
Wie misst man, ob eine KI-Dokumentation gut ist? Dieses Modul stellt gängige Benchmarks vor – von der Wortfehlerrate über Rouge-Metriken bis zu künstlich generierten Testgesprächen. Ein zentrales Learning: Nicht Halluzinationen, sondern Omissionen – fehlende, aber relevante Inhalte – sind das häufigere und schwerer zu findende Problem. Beleuchtet wird auch das „Nadel-im-Heuhaufen"-Dilemma: Je aufwendiger die Fehlersuche, desto geringer der tatsächliche Zeitgewinn. Es wird darüber gesprochen, warum Idealbedingungen im Labor selten der klinischen Realität entsprechen. Auch Dialekte und die besondere Herausforderung der deutschen Sprache werden eingeordnet, bevor Teilnehmende vier konkrete Fragen für strukturierte Anbietergespräche zur kritischen Bewertung von Studienlage und Testbedingungen erhalten.
Kanal
Schlagworte
Anbietervergleich KI Medizin
Ausgelassene Angaben Arztbrief
Benchmarking Gesundheits-KI
Confidence Score Diktat
Deutsche Testdaten Spracherkennung
Dialekterkennung Software
Erkennungsgenauigkeit stationär
Faktentreue Prüfung
Goldstandard Vergleich
Intensivstation Testszenario
Klinische Validierung Software
Laborbedingungen KI
Modellwahl Spracherkennung
Peer-Review KI-Forschung
Qualitätskriterien KI-Text
Reale Einsatzbedingungen
Textähnlichkeitsmaß
Umgebungsgeräusche Testung
Virtuelle Testszenarien
Vorklinische Evaluation KI
